讀完這篇,你會帶走
- 廠商公布的基準測試反映指定條件,不保證你的文件與工作流有同樣結果。
- 用相同輸入、工具與評分規則比較現行模型和候選模型,並重複試跑。
- 把答案品質、工具行為、每件任務的資源消耗與失敗處理一起驗收。
OpenAI 在 9 月 29 日發布 GPT-6.1 Sol,並公布程式開發、複雜 PDF、跨工具業務流程與電腦操作等評測結果。[1] 這些資訊有助於列出候選模型,但測試任務、工具、推理設定與成本口徑,都未必等於你公司的實際環境。換模型之前,先把現行流程留作比較基準。
01 / 官方評測能告訴我們什麼?
OpenAI 的公告指出,GPT-6.1 Sol 在指定的 AutomationBench、GDP.pdf、OSWorld 等測試有進步,並列出各自的任務和成本比較。[1] 其中事實性測試使用曾被使用者標示出錯的困難對話,官方也明言不代表一般使用情況。這是廠商公布的研究或 API 測試結果,不能直接換算成企業自己的正確率、節費幅度或上線資格。
02 / 先固定一批自己的任務
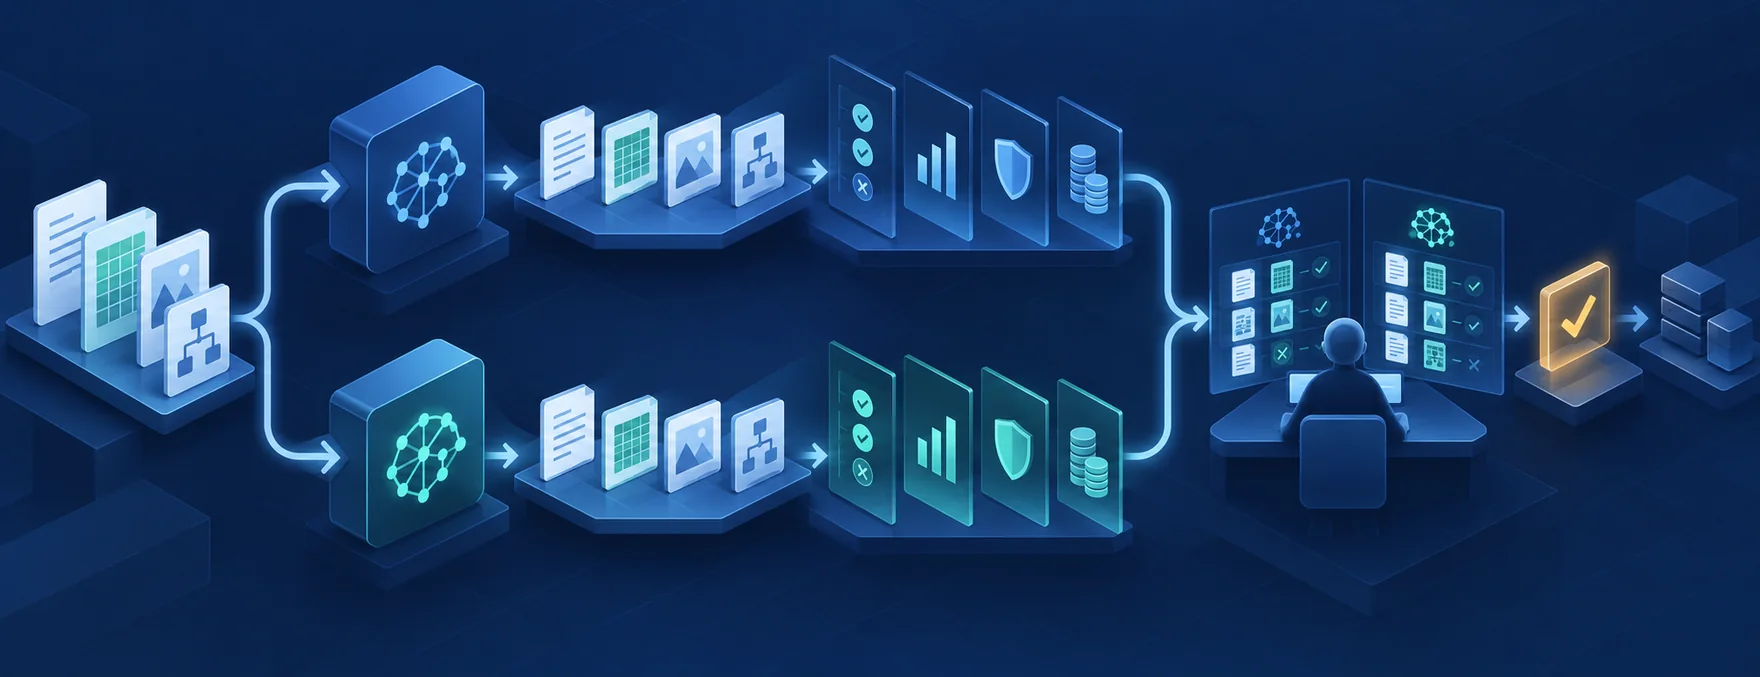
編輯建議:從一條已有人負責的流程,選出正常、邊界與曾出錯的任務。保留相同輸入、工具權限、輸出格式、成功條件及人工審閱方式,分別交給現行與候選模型。若調整了提示詞或工具,請另外記錄版本,避免把多項改動混成『換模型的效果』。測試資料應去識別化,避免把客戶或員工資料直接送進試跑。
Anthropic 的工程文章將一個評測拆成任務、試跑、評分器與完整執行軌跡;同一任務要跑多次,才能看出輸出變動。[2] 這是測試方法參考,不代表本篇已對 GPT-6.1 Sol 或其他模型做實測。
03 / 四項驗收,缺一項就先不要擴大
| 驗收面向 | 先核對什麼 | 留存的證據 |
|---|---|---|
| 答案品質 | 事實、引用、格式與不確定時的回答 | 逐題評分與人工修正紀錄 |
| 工具與權限 | 是否照規則呼叫工具、遇到禁止操作是否停止 | 執行軌跡與異常案例 |
| 資源消耗 | 每件完成任務的費用、等待時間與重試次數 | 同一批任務的用量與時間記錄 |
| 失敗處理 | 搜尋失效、缺資料或工具報錯時有沒有說明並交還人工 | 失敗輸入、回應及處理決定 |
這四項是供團隊自行設定門檻的編輯建議,不是 OpenAI 或 Anthropic 宣稱的通用驗收標準。成本也應以『完成一件合格任務』觀察;只比較每百萬 token 標價,可能忽略較長輸出、重試與人工修正。價格及模型可用性會變動,採購前仍須核對當時官方頁面與自身方案。[1]
04 / 留下一張能複查的切換紀錄
- 記錄任務集版本、資料來源與去識別化方式,並指定負責審閱的人。
- 固定模型、提示詞、工具、權限與推理設定;每次修改另開一筆。
- 對每項任務保留現行與候選模型的結果、評分、資源消耗及失敗軌跡。
- 先定義哪些錯誤必須退回、何時維持原模型,以及由誰決定分階段切換。
資料來源
- Introducing GPT-6.1 Sol ↗OpenAI · 原文 2026-09-29
2026-10-02 以 Firecrawl maxAge=0 查閱官方全文;產品能力、比較與價格均屬 OpenAI 公布的特定測試或當時資訊,本文不推論企業實際成效。
- Demystifying evals for AI agents ↗Anthropic Engineering · 原文 2026-01-09
2026-10-02 以 Firecrawl maxAge=0 查閱官方工程全文;作為測試設計方法參考,不視為本週產品消息。
來源查閱:2026-10-02。本文含 AI 協助整理;已完成編輯核准。